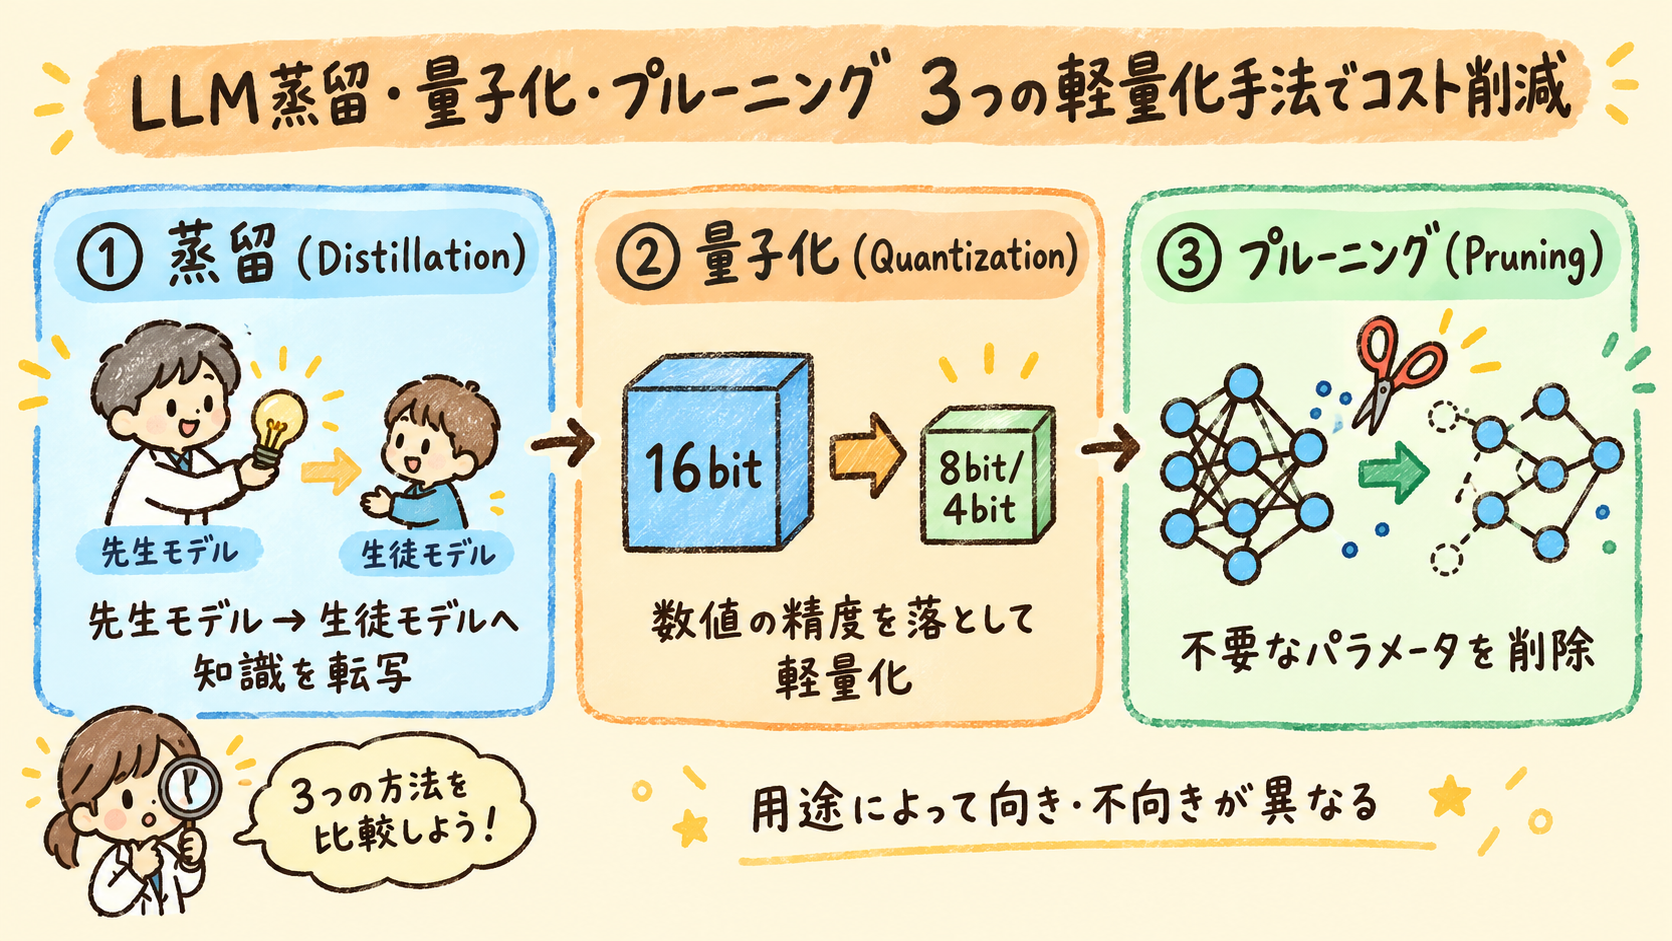
 図1:LLM蒸留・量子化・プルーニングという3つの軽量化手法の全体像
LLM蒸留とは、性能の高い教師モデルの知識を軽量な生徒モデルに移すことで、推論コストを抑えながら精度を維持する軽量化手法です。代表例のDistilBERTでは、モデルサイズを40%削減し推論速度を60%高速化しながら、元モデルの性能の97%を維持できることが確認されています。ただし、蒸留だけがLLM運用コストの答えとは限りません。量子化やプルーニングといった他の軽量化手法との使い分けを誤ると、精度劣化や実装コストの増大を招きます。
「精度をどこまで落とせるか分からず投資判断ができない」「どの軽量化手法を選べばいいか基準がない」——こうした悩みを持つDX担当者・情シス担当者は多いのではないでしょうか。本記事では、蒸留・量子化・プルーニングの仕組みを整理したうえで、一次情報に基づく精度・コストのトレードオフと、企業導入シーン別の推奨手法を解説します。
- 蒸留・量子化・プルーニングそれぞれの仕組みと得意分野の違い
- 3手法の精度・コスト・実装難易度を、一次情報の数値で比較した結果
- モデルの再学習が必要かどうかによる、導入のしやすさの違い
- 導入前に確認しておきたい、手法ごとに必要な人材・スキルの目安
- 社内チャットボット・エッジ・リアルタイム推論・バッチ処理など、企業導入シーン別に向いている手法
LLM蒸留とは?
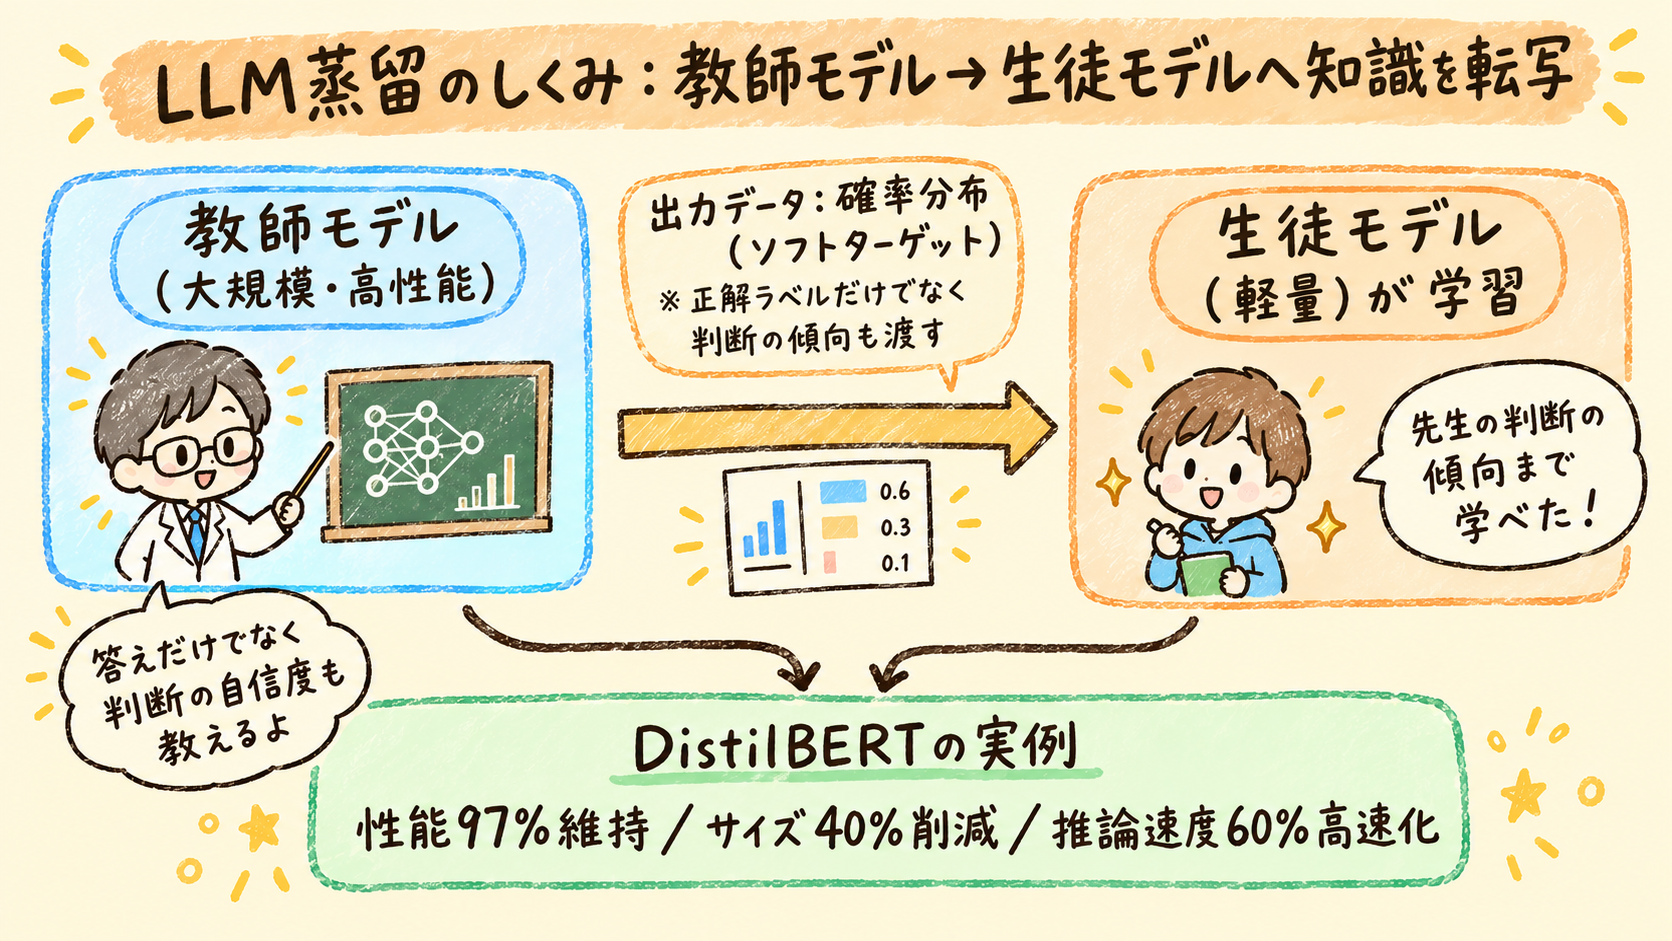 図2:LLM蒸留は教師モデルの確率分布(ソフトターゲット)を生徒モデルが学習する仕組みで、DistilBERTでは性能97%を維持しながら軽量化を実現する
LLM蒸留とは、性能の高い教師モデルの出力を学習データとして使い、軽量な生徒モデルに知識を転写する手法です。現在広く使われている知識蒸留の枠組みは、2015年にHintonらが発表した研究によって広く知られるようになりました。生徒モデルは正解ラベルだけでなく、教師モデルが各選択肢に対して示す確率分布(ソフトターゲット)も学習します(Distilling the Knowledge in a Neural Network)。
教師モデルを先生、蒸留後のモデルを生徒に置き換えるとイメージしやすくなります。生徒モデルは先生が出した最終的な答えだけでなく、先生が各選択肢にどの程度自信を持っていたかという判断の傾向まで学習の対象にします。この仕組みにより、生徒モデルはパラメータ数を大きく減らしても、教師モデルの判断パターンに近い出力ができるようになります。
蒸留の効果を示す代表例が、BERTを蒸留したDistilBERTです。DistilBERTは元モデルと比べてモデルサイズを40%削減し、推論速度を60%高速化しながら、言語理解性能の97%を維持できることが報告されています(DistilBERT, a distilled version of BERT: smaller, faster, cheaper and lighter)。Googleが開発したGemma 2も、27Bモデルを教師として9Bモデルと2Bモデルの学習に蒸留を採用しており、大規模モデルの性能を小型モデルに落とし込む手段として実運用されています(Gemma explained: What's new in Gemma 2)。
蒸留の実装には、教師モデルからの学習データ生成と生徒モデルの再学習が必要になるため、実装難易度は中〜高となります。
▼ 蒸留の詳しい解説記事はこちら
www.elcamy.com リンク先の情報を読み込み中...https://www.elcamy.com
量子化でモデルはどう軽くなる?
量子化とは、モデル内部の数値表現の精度を落とすことで、メモリ使用量と計算量を削減する軽量化手法です。具体的には、16bit(FP16・BF16など)で扱われることが多いモデルの数値を、8bitや4bitの整数、あるいはFP8・NVFP4のような低ビットの浮動小数点形式に置き換えます。蒸留と異なり、多くの場合で追加学習が不要な「Post-Training Quantization(PTQ、学習後の量子化)」が主流のため、実装難易度は低〜中にとどまります。
量子化にはINT8・INT4・FP8などいくつかの精度レベルがあり、精度を落とす幅が大きいほどメモリ削減効果は高まりますが、その分だけ精度劣化のリスクも上がります。どの精度レベルを選ぶかは、モデルの用途と許容できる精度劣化の大きさで判断します。
NVIDIAの検証では、Blackwell世代GPU向けのNVFP4(NVIDIA独自の4bit浮動小数点形式)による量子化を適用したQwen 23B(NVIDIA公式ブログの表記)・DeepSeek-R1-0528・Llama Nemotron Ultraにおいて、ほぼすべての精度を維持しながら最大2〜3倍のスループット(単位時間あたりの処理件数)改善が確認されています(Optimizing LLMs for Performance and Accuracy with Post-Training Quantization)。また、Google Cloudの解説によると、モデルの重みをFP16からINT8・INT4に減らすことでメモリ使用量を1/2〜1/4に削減できるとされています。さらに、デコードフェーズはメモリ帯域幅に制約されるため、INT4形式の重みはFP16比で読み取り速度が最大4倍高速になるとされています(LLM 推論の効率的フロンティアに到達するための5つの手法)。つまり、AWQ・GPTQなどの手法を用いれば、量子化は精度をほとんど落とさずに、メモリ使用量とスループットの両面でコスト効率を高められる手法だと言えます。
NVIDIAのTensorRT-LLMはAWQ・GPTQ(いずれも量子化アルゴリズムの一種)形式のINT4量子化に対応しており、既存モデルを再学習せずにメモリ効率を高められる点が実務での使いやすさにつながっています(TensorRT-LLM公式ドキュメント「Numerical Precision」)。
プルーニングの仕組みは?
プルーニングとは、モデル内の重要度が低い重みや構造を削除・無効化し、計算量やモデルサイズの削減を図る手法です。大きく2種類に分けられます。
| 種類 | 削除の単位 | 特徴 |
|---|---|---|
| 非構造化プルーニング | パラメータ単位 | 削除の自由度は高いが、専用のハードウェア・ソフトウェア対応がないと高速化を実現しにくい |
| 構造化プルーニング | 層・ヘッド単位でまとめて削除 | 一般的なハードウェアでも高速化効果を得やすいとされている |
学術研究のSparseGPTでは、OPT-175BやBLOOM-176Bといった大規模モデルに対して、50%のスパース化(パラメータの半分を無視できる状態にすること)を適用しても、予測精度の指標であるperplexity(パープレキシティ)の悪化はごくわずかであることが示されています。さらに60%まで拡張しても、同様にperplexityの悪化はわずかにとどまることが確認されています(SparseGPT: Massive Language Models Can Be Accurately Pruned in One-Shot)。この結果は、数千億パラメータ規模の大規模モデルにも、精度への影響を抑えながら削減できる重みが多く存在する可能性を示しています。大規模モデルでは1,000億以上のパラメータを推論時に無視できる計算になります。
一方で、非構造化プルーニングは専用のハードウェア・ソフトウェアが対応していないと理論上の高速化を実現できない場合があり、実装難易度は中〜高になります。
3手法の精度とコストはどう違う?
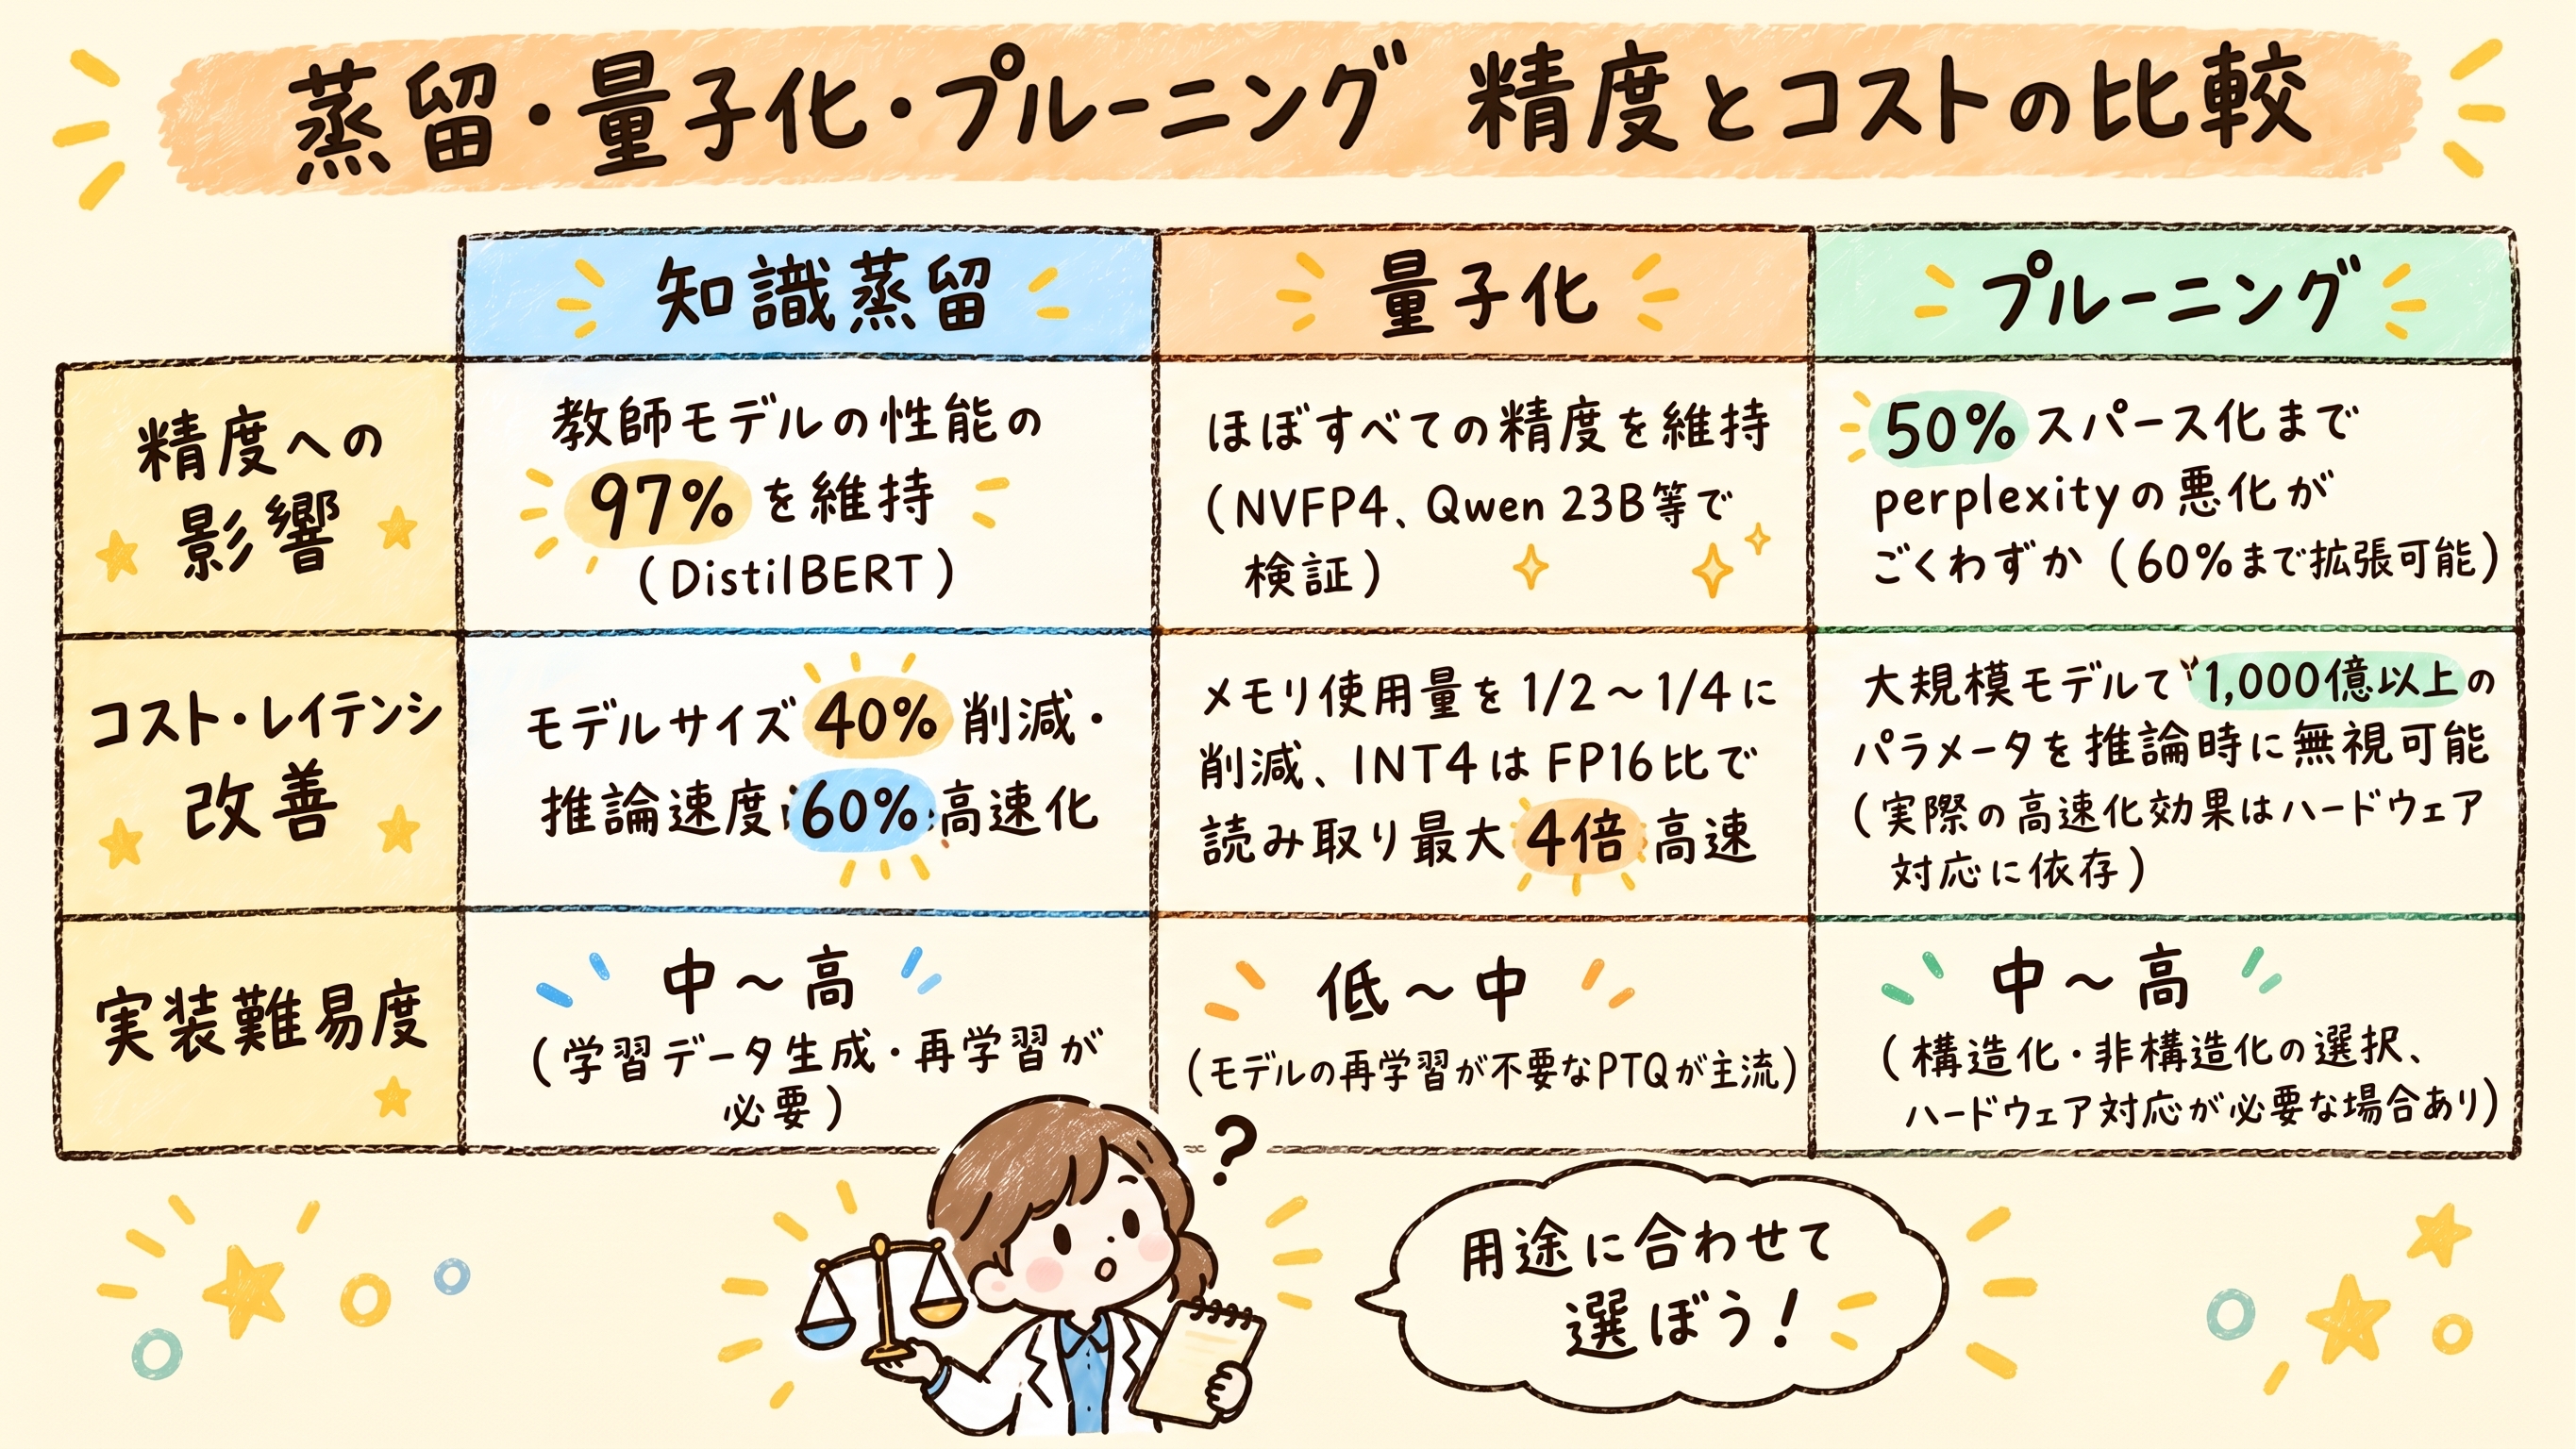 図3:蒸留・量子化・プルーニングの精度・コスト・実装難易度を一次情報の数値で比較した表
蒸留・量子化・プルーニングは、精度への影響の度合い・コスト(レイテンシを含む改善効果)・実装難易度がそれぞれ異なります。以下の表は、各手法について確認できた一次情報の数値をまとめたものです。ただし、検証対象のモデル・評価指標・ハードウェアは手法ごとに異なるため、数値を横並びで優劣比較することはできません。各手法の効果の目安としてご覧ください。
| 指標 | 知識蒸留 | 量子化 | プルーニング |
|---|---|---|---|
| 精度への影響 | 教師モデルの性能の97%を維持(DistilBERT) | ほぼすべての精度を維持(NVFP4、Qwen 23B等で検証) | 50%スパース化までperplexityの悪化がごくわずか(60%まで拡張可能) |
| コスト・レイテンシ改善 | モデルサイズ40%削減・推論速度60%高速化 | メモリ使用量を1/2〜1/4に削減、INT4はFP16比で読み取り最大4倍高速 | 大規模モデルで1,000億以上のパラメータを推論時に無視可能(実際の高速化効果はハードウェア対応に依存) |
| 実装難易度 | 中〜高(学習データ生成・再学習が必要) | 低〜中(モデルの再学習が不要なPTQが主流) | 中〜高(構造化・非構造化の選択、ハードウェア対応が必要な場合あり) |
この表からは、実装のしやすさを優先するなら量子化、モデル構造自体を作り替えて長期的なコスト効率を追求するなら蒸留、大規模モデルの冗長なパラメータを絞り込みたいならプルーニングという、異なる強みが読み取れます。3手法は択一ではなく、量子化した上でさらにプルーニングを組み合わせるなど、併用することも可能です。
企業導入ではどの手法を選ぶべき?
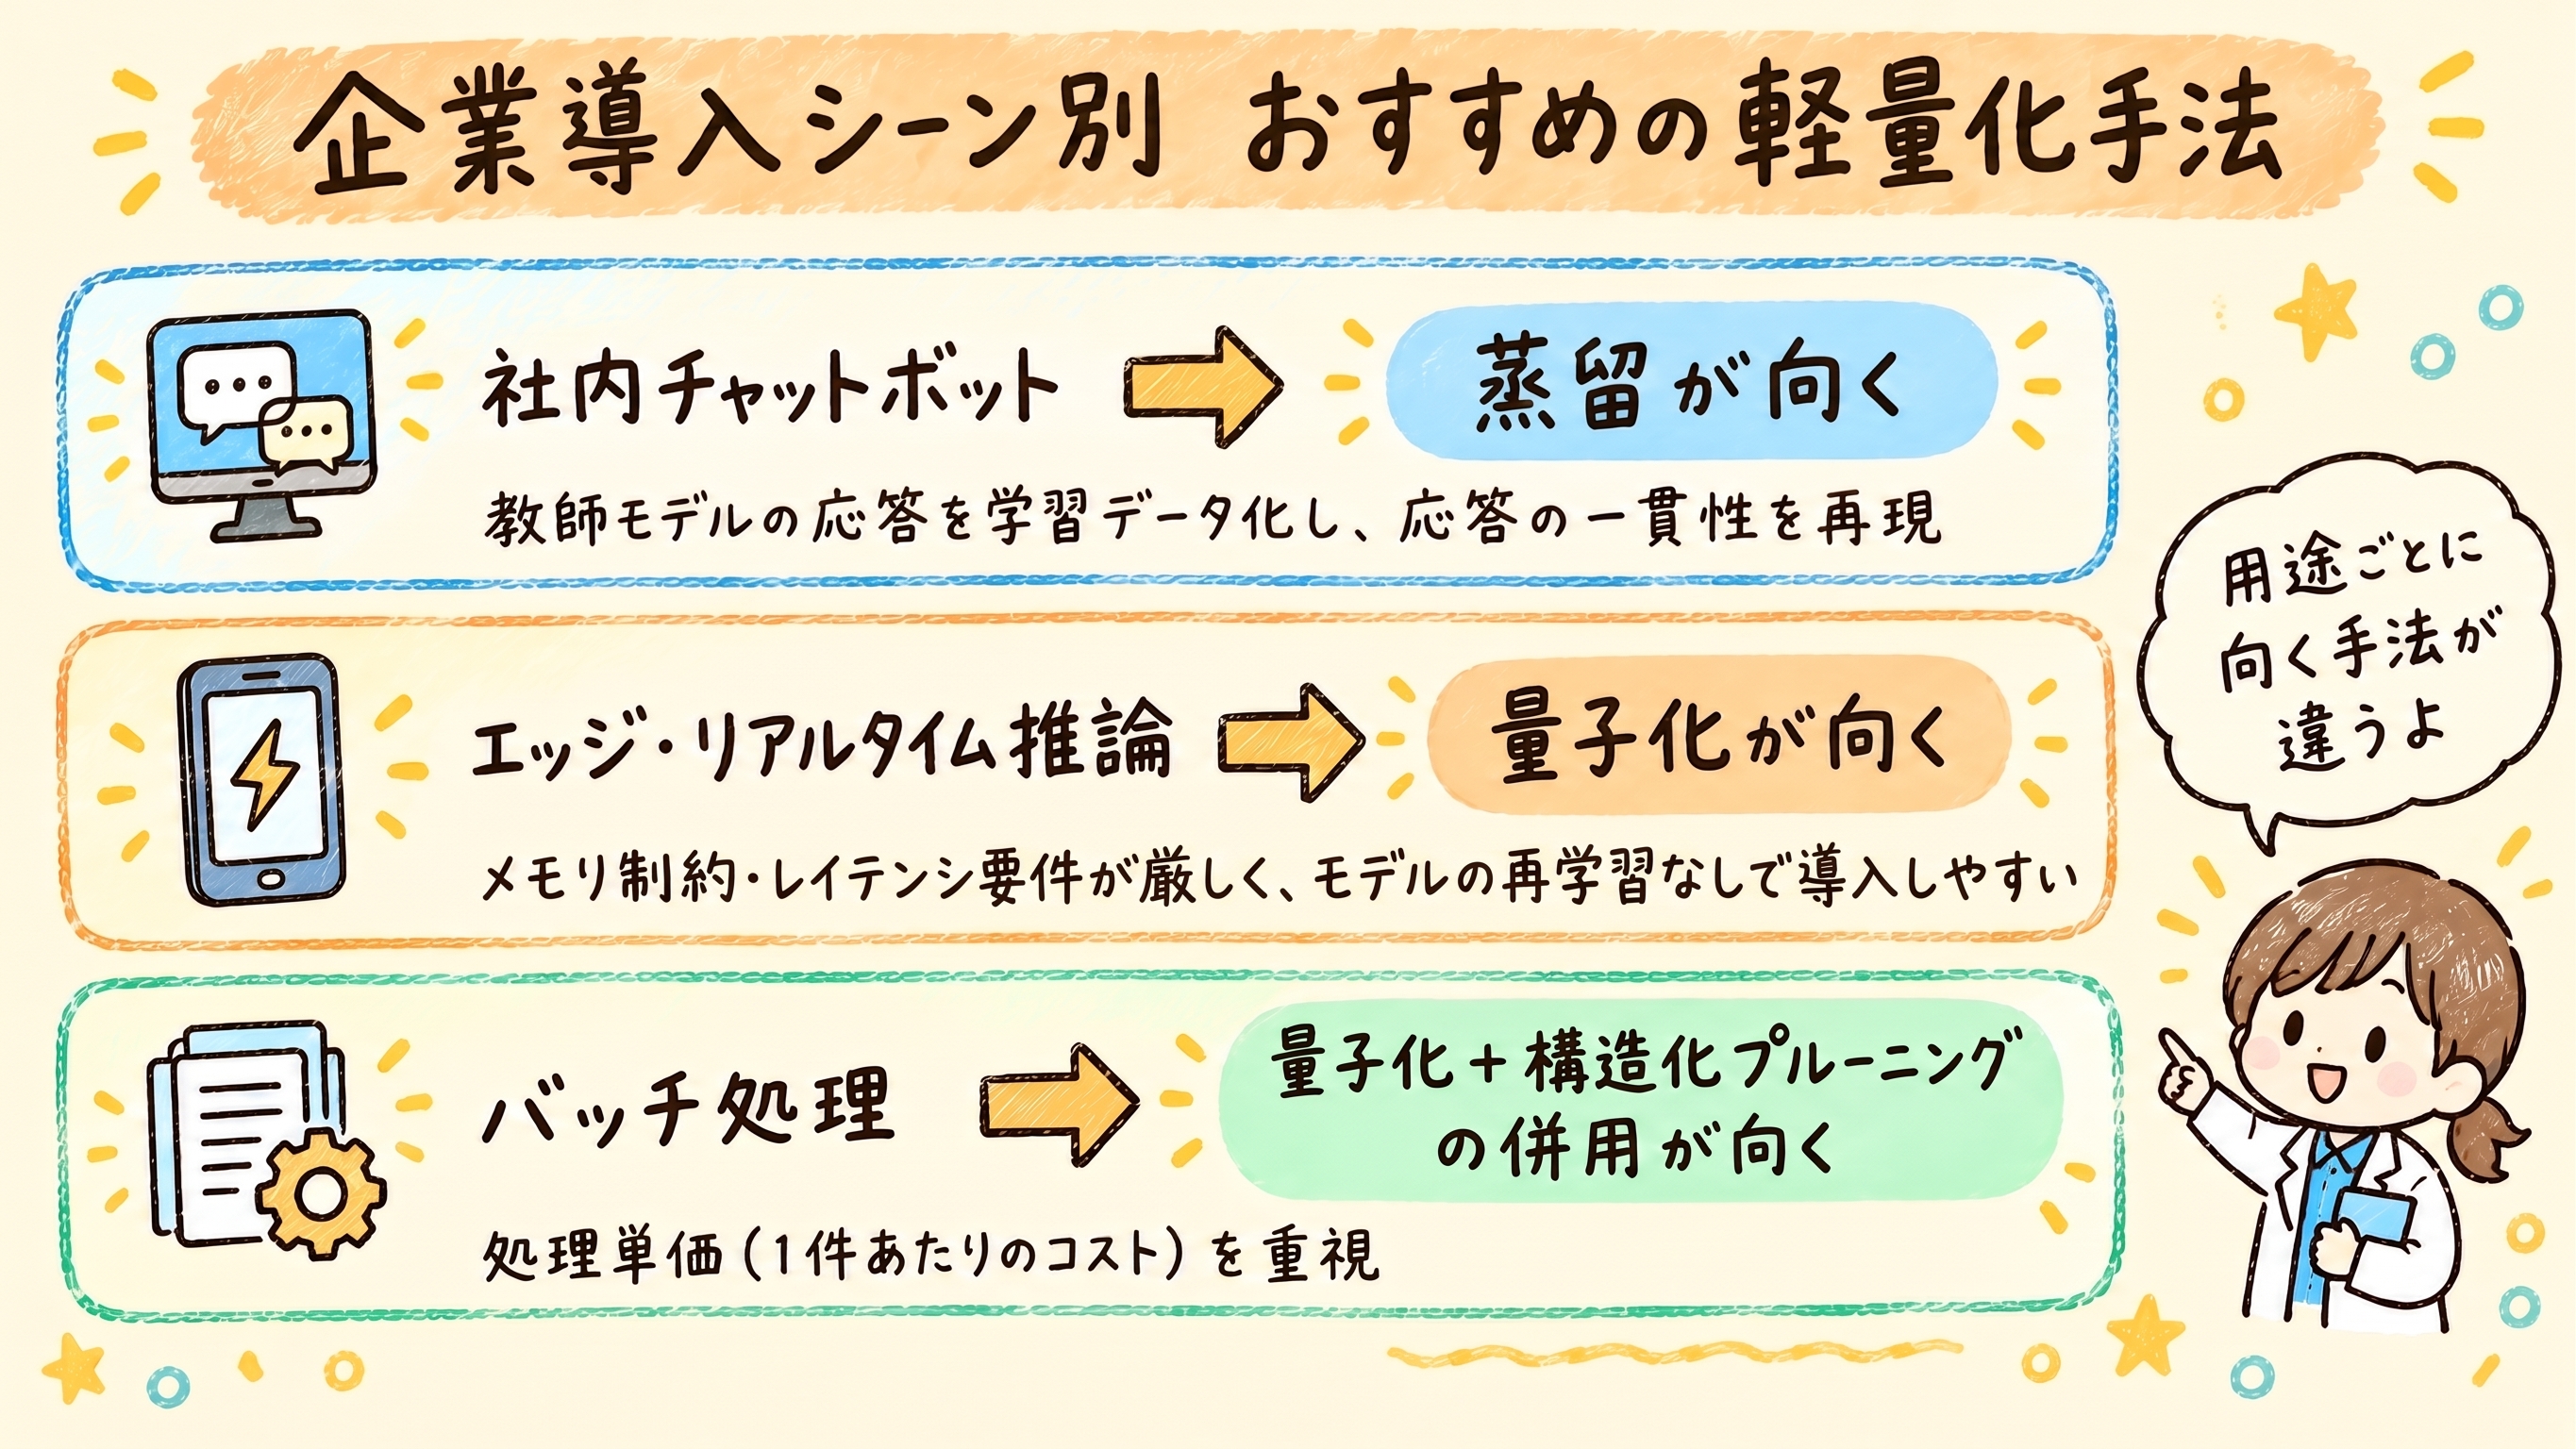 図4:企業導入シーン別(社内チャットボット/エッジ・リアルタイム推論/バッチ処理)のおすすめ軽量化手法
企業導入では、社内チャットボット・エッジ・リアルタイム推論・バッチ処理といったユースケースによって、優先すべき軽量化手法が変わります。
| ユースケース | 推奨手法 | 主な理由 |
|---|---|---|
| 社内チャットボット | 蒸留 | 教師モデルの応答パターンを学習し、応答の一貫性を再現しやすい |
| エッジ・リアルタイム推論 | 量子化 | モデルの再学習が不要で導入しやすく、メモリ制約・レイテンシ要件に対応しやすい |
| バッチ処理 | 量子化+半構造化(2:4)スパース化 | 処理単価(1件あたりのコスト)を重視し、GPUの演算量を直接減らせる |
以下でそれぞれの理由を詳しく解説します。
社内チャットボットには蒸留が向く?
社内チャットボットのように応答の一貫性が重視される用途では、蒸留が有力な選択肢になります。自社の業務プロンプトに対する教師モデルの応答を学習データとして収集し、その応答パターンを生徒モデルに学習させることで、軽量なモデルでも自社の業務文脈に合った応答を再現しやすくなるためです。
OpenAIは2024年10月のDevDayで、教師モデルの出力を学習データとして小型モデルをファインチューニングする「Model Distillation」機能をAPIに追加しました(Model Distillation in the API)。教師モデルの応答パターンをそのまま学習に使うため、生徒モデルは教師モデルに近い応答を再現しやすくなり、企業は応答品質を保ちながらAPI利用コストを抑えた小型モデルを構築しやすくなっています。
エッジ・リアルタイム推論には量子化が向く理由は?
エッジデバイスやリアルタイム推論では、メモリ制約とレイテンシ(応答が返るまでの遅延時間)要件が厳しいため、モデルの再学習が不要で導入しやすい量子化が向いています。追加学習なしでモデルサイズを縮小できるため、開発期間を短縮しながらオンプレミス・デバイス上での動作を実現しやすくなります。
Microsoftの小型言語モデル(SLM)であるPhi-3は、スマートフォンなどローカル環境での動作を想定して設計されています(Phi-3 Technical Report: A Highly Capable Language Model Locally on Your Phone)。このように限られた計算資源での動作を前提とした小型モデルは、量子化と組み合わせることでさらにメモリ・演算コストを抑えやすくなります。
バッチ処理には量子化とプルーニングの併用が有効?
バッチ処理のようにスループットが重視される用途では、量子化と半構造化スパース化(2:4など)の併用が選択肢になります。SparseGPTの検証では、2:4スパース化によってOPT-175Bの層単位の演算が約1.5〜1.8倍高速化し、さらに4bit量子化を重ねても精度の悪化はわずかでした(SparseGPT)。ただし、2:4は非構造化のスパース化より精度が落ちやすく、高速化には対応するGPU(NVIDIAではAmpere世代以降)が必要です。
導入前に確認すべき実装難易度・人材要件は?
各手法は実装難易度と必要な社内人材のスキルセットが異なるため、導入前には自社のAI・データ人材の有無を確認しておく必要があります。
| 手法 | 必要な人材・スキル | 備考 |
|---|---|---|
| 蒸留 | 学習データ生成・再学習ができる専門人材 | 専門人材が確保できない企業にはハードルが高くなりがち |
| 量子化 | 量子化ツールの運用・精度検証ができる技術者(モデル再学習スキルは不要) | モデルの再学習が不要なPTQが主流のため、専任のML研究者がいなくても着手しやすい |
| プルーニング | ハードウェア対応を検証できるインフラ担当者 | 構造化・非構造化の選択とハードウェア対応の見極めが必要 |
まとめ
LLM蒸留とは、コスト削減を目的に教師モデルの知識を軽量な生徒モデルへ移す軽量化手法の一つです。本記事のポイントをまとめます。
- 蒸留:教師モデルの判断傾向まで学習させる手法で、DistilBERTでは性能97%維持・40%小型化・60%高速化を実現しています
- 量子化:数値表現の精度を落として軽量化する手法で、モデルの再学習が不要なPTQが主流のため実装しやすい手法です
- プルーニング:不要なパラメータを削除する手法で、大規模モデルでは50〜60%のスパース化でもperplexityの悪化がごくわずかです(小規模モデルほど精度が落ちやすくなります)
- 3手法は実装コストと長期的なコスト効率のトレードオフが異なり、単独でも併用でも選択できます
- 社内チャットボットには蒸留、エッジ・リアルタイム推論には量子化、バッチ処理には量子化と構造化プルーニングの併用が向いています
- 導入前には社内のAI・データ人材の有無を踏まえて、実装難易度を見極める必要があります
自社のユースケースと社内の人材体制を照らし合わせながら3手法を適切に使い分けることで、精度を大きく落とさずにLLM運用コストを抑えられます。
出典一覧
- 「Distilling the Knowledge in a Neural Network」 — Hinton, Vinyals, Dean(2015-03-09)
- 「DistilBERT, a distilled version of BERT: smaller, faster, cheaper and lighter」 — Sanh et al. / Hugging Face(2019-10-02)
- 「SparseGPT: Massive Language Models Can Be Accurately Pruned in One-Shot」 — Frantar & Alistarh(ICML 2023)(2023-01-02)
- 「Model Distillation in the API」 — OpenAI(2024-10-01)
- 「Optimizing LLMs for Performance and Accuracy with Post-Training Quantization」 — NVIDIA Technical Blog(2025-08-01、2026-03-06更新)
- TensorRT-LLM公式ドキュメント「Numerical Precision」 — NVIDIA(2025-09-15)
- 「LLM 推論の効率的フロンティアに到達するための5つの手法」 — Google Cloud(2026-04-08、原文公開: 2026-03-28)
- 「Gemma explained: What's new in Gemma 2」 — Google Developers Blog(2024-08-22)
- 「Phi-3 Technical Report: A Highly Capable Language Model Locally on Your Phone」 — Microsoft(2024-04-22)
関連サイト
- Hugging Face Transformers — bitsandbytes・GPTQ・AWQなど量子化手法を公式に統合したオープンソースライブラリ(蒸留は標準APIではなくサンプルスクリプト等での対応が中心)
執筆者:えだまめ
Elcamyでバックオフィスとブログ執筆を担当。AI未経験の状態からAI活用を学び、Claude CodeをはじめとするAIエージェントの実務活用法を発信している。
更新情報はElcamy公式Xでも発信中。